Faire tourner sa propre IA chez soi : quel ordinateur faut-il vraiment en 2026 ?
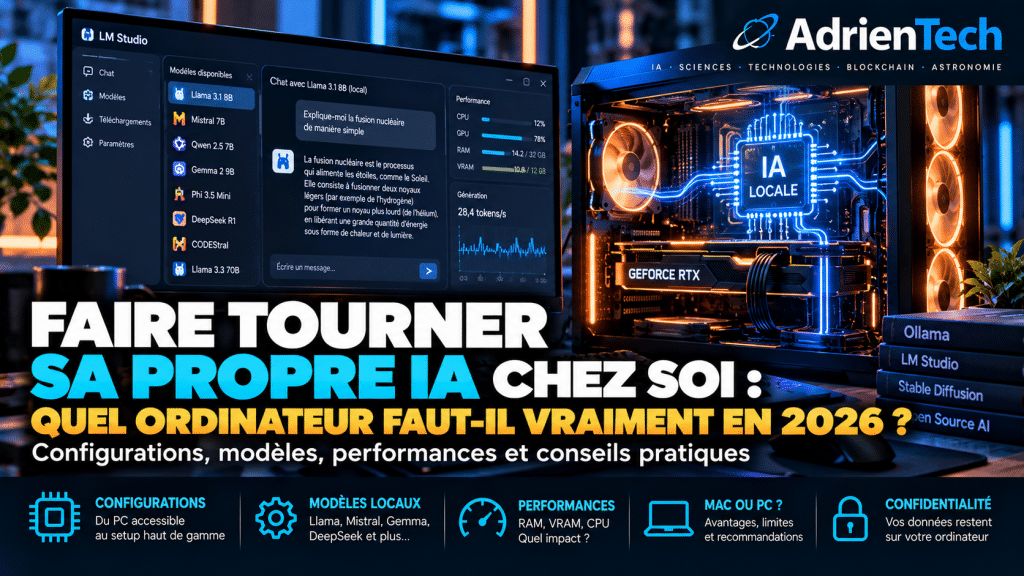
Et si votre prochain assistant IA fonctionnait directement sur votre ordinateur, sans abonnement mensuel et sans envoyer systématiquement vos données vers le cloud ? Cette possibilité est déjà accessible. Grâce à des logiciels comme Ollama et LM Studio, il est aujourd’hui possible d’exécuter des modèles d’intelligence artificielle sur un PC ou un Mac personnel.
Mais une question se pose rapidement : faut-il investir dans une carte graphique coûteuse, acheter un Mac doté de beaucoup de mémoire ou simplement essayer avec l’ordinateur que l’on possède déjà ?
La réponse dépend moins de la puissance générale de la machine que de son utilisation, de la taille des modèles et, surtout, de la mémoire disponible. En 2026, il est possible de commencer modestement, mais certaines ambitions nécessitent encore du matériel conséquent.
Pourquoi installer une IA sur son propre ordinateur ?
Lorsqu’on utilise ChatGPT, Claude ou Gemini en ligne, les calculs sont principalement effectués sur des serveurs distants. L’ordinateur sert essentiellement d’interface. Avec une IA locale, une partie essentielle du traitement est réalisée directement sur la machine de l’utilisateur.
Cette approche présente plusieurs avantages.
Le premier est la confidentialité. Les documents, notes personnelles ou extraits de code transmis à un modèle local peuvent rester sur l’ordinateur, à condition de configurer correctement les logiciels et de ne pas activer de services externes. Pour un professionnel qui manipule des informations sensibles, c’est un argument important.
Le deuxième avantage est l’autonomie. Une fois le modèle téléchargé, certaines utilisations ne nécessitent plus de connexion Internet. L’accès ne dépend pas non plus d’un abonnement à un service d’IA distant, même si l’électricité, le matériel et le temps de maintenance ont évidemment un coût.
Enfin, l’utilisateur gagne en liberté. Il peut tester plusieurs modèles, comparer leurs réponses, automatiser des tâches et créer ses propres outils.
Cette évolution prolonge celle que nous évoquions dans notre article consacré à l’IA locale sur PC et smartphone. Le cloud restera indispensable pour de nombreux usages, mais il ne sera plus nécessairement le point de passage obligé pour chaque requête.
La mémoire : le critère qui change tout
Lorsqu’on choisit un ordinateur pour jouer, on regarde souvent le processeur, la carte graphique et les performances dans les jeux. Pour exécuter un modèle de langage local, un autre élément devient central : la mémoire.
Il faut distinguer deux ressources.
- La RAM, ou mémoire vive, sert notamment au système d’exploitation et aux applications. Elle peut aussi accueillir une partie du modèle.
- La VRAM est la mémoire dédiée à la carte graphique. Elle permet au GPU de conserver les paramètres du modèle à proximité des unités de calcul, ce qui favorise généralement des réponses plus rapides.
Sur un PC équipé d’une carte graphique dédiée, ces deux mémoires sont distinctes. Sur les Mac à puce Apple Silicon, la mémoire unifiée est partagée entre le processeur, le GPU et les autres composants.
La taille du modèle joue également un rôle majeur. Un modèle de quelques milliards de paramètres est généralement plus facile à faire tourner qu’un modèle de plusieurs dizaines de milliards de paramètres. La quantification, une technique qui réduit la précision numérique des paramètres, permet de diminuer l’empreinte mémoire au prix d’une éventuelle perte de qualité.
À titre indicatif, un modèle de 8 milliards de paramètres quantifié sur 4 bits peut occuper environ 5 à 6 Go pour ses poids. Il faut ensuite prévoir de la mémoire supplémentaire pour le contexte, les caches et le système. Les besoins réels varient selon le modèle et les réglages.
Le principe est simple : plus le modèle est gros, plus il faut de mémoire ; si le modèle ne tient pas dans la mémoire rapide disponible, les performances peuvent fortement diminuer.
Quel ordinateur selon son budget et ses ambitions ?
Les configurations ci-dessous sont des repères techniques, pas des prix garantis. Les tarifs suisses varient selon les marques, les promotions et les composants retenus.
1. Pour découvrir l’IA locale : un ordinateur déjà disponible
<text>Configuration indicative : 16 Go de RAM, processeur récent et, si possible, SSD.</text>
Il n’est pas nécessaire d’acheter immédiatement une nouvelle machine. Un ordinateur récent doté de 16 Go de mémoire peut suffire pour tester des modèles compacts, discuter avec un assistant local, résumer de courts textes ou expérimenter avec du code.
Les performances dépendront du processeur, de la mémoire disponible et du modèle choisi. Sans carte graphique adaptée, la génération des réponses pourra être plus lente, mais cela ne rend pas l’expérience inutile.
C’est le meilleur point de départ pour comprendre les possibilités et les limites de l’IA locale avant de dépenser de l’argent.
2. Pour un usage régulier : 32 Go de RAM et une carte graphique adaptée
<text>Configuration indicative : 32 Go de RAM et GPU avec 12 à 16 Go de VRAM.</text>
C’est un compromis intéressant pour les personnes qui souhaitent utiliser l’IA régulièrement : rédaction, assistance à la programmation, analyse de documents et expérimentation avec plusieurs modèles.
La mémoire graphique devient ici un critère déterminant. Une carte dotée de 16 Go de VRAM offre davantage de marge pour les modèles intermédiaires qu’une carte limitée à 8 Go, même si les performances de calcul restent également importantes.
Les cartes NVIDIA sont particulièrement répandues dans cet univers, grâce à leur écosystème logiciel et à la prise en charge de nombreuses bibliothèques d’IA. Les caractéristiques officielles des GeForce RTX série 50 permettent notamment de comparer la mémoire embarquée selon les modèles.
Attention cependant : une carte graphique puissante pour les jeux n’est pas automatiquement le meilleur achat pour l’IA. À budget comparable, la quantité de VRAM peut compter davantage que certains gains de performances dans les jeux.
3. Pour des modèles plus ambitieux : 24 Go de VRAM ou davantage
<text>Configuration indicative : 64 Go de RAM système et GPU avec 24 Go de VRAM, ou plus selon le modèle visé.</text>
Cette catégorie s’adresse aux passionnés, développeurs et utilisateurs qui veulent expérimenter avec des modèles plus volumineux, des contextes plus longs ou des tâches complexes.
Une carte graphique disposant de 24 Go de VRAM offre davantage de possibilités, notamment pour certains modèles de plusieurs dizaines de milliards de paramètres quantifiés. Elle ne garantit toutefois pas que n’importe quel modèle fonctionnera confortablement : la mémoire requise dépend aussi de la quantification, de la longueur du contexte et des fonctions activées.
Les très gros modèles peuvent dépasser les capacités d’un ordinateur personnel classique. Il est parfois possible de les charger partiellement en RAM, mais cette solution peut réduire considérablement la vitesse de génération.
Avant d’acheter une carte coûteuse, mieux vaut donc choisir d’abord les modèles que l’on souhaite réellement utiliser.
Mac ou PC : quelle plateforme privilégier ?
Les deux approches sont pertinentes, mais elles ne répondent pas exactement aux mêmes besoins.
Le Mac présente un avantage : sa mémoire unifiée permet au GPU et au processeur de partager un même espace mémoire. Cela peut faciliter l’exécution de modèles relativement volumineux sur une machine compacte, sans carte graphique dédiée.
Un Mac mini doté d’une puce Apple Silicon peut donc constituer une solution intéressante pour un usage domestique. Il faut toutefois choisir la quantité de mémoire avec soin : elle n’est pas destinée à être augmentée ultérieurement comme sur de nombreux PC de bureau. Les spécifications officielles du Mac mini détaillent les configurations de mémoire proposées pour les différentes puces.
Le PC Windows, de son côté, offre davantage de possibilités de personnalisation. Il est possible de remplacer la carte graphique, d’augmenter la RAM sur une plateforme compatible ou de construire une machine adaptée à un besoin précis. Cette flexibilité peut être particulièrement intéressante pour ceux qui veulent aussi jouer, monter des vidéos ou développer des applications.
En pratique, le Mac est séduisant pour une solution compacte et simple, tandis que le PC équipé d’un GPU NVIDIA constitue souvent un choix polyvalent pour qui veut optimiser ses performances et faire évoluer sa configuration.
Les logiciels pour commencer sans être développeur
Le matériel ne suffit pas : il faut également un logiciel capable de télécharger et d’exécuter les modèles.
Deux outils se distinguent.
Ollama facilite l’installation et l’exécution de nombreux modèles locaux. Il propose une interface en ligne de commande et des possibilités d’intégration dans d’autres applications. Son catalogue permet notamment d’essayer différents modèles de langage, avec des versions adaptées à des capacités matérielles variées.
LM Studio mise davantage sur une interface graphique. L’utilisateur peut rechercher un modèle, le télécharger, le charger en mémoire puis dialoguer avec lui sans devoir commencer par manipuler un terminal. La documentation officielle précise les exigences selon le système d’exploitation et recommande notamment 16 Go de RAM pour les configurations courantes.
Pour un premier essai, ces deux outils sont plus pertinents que de chercher immédiatement à construire une infrastructure complexe. Le catalogue Ollama permet de comparer les tailles et les variantes disponibles.
Il faut néanmoins garder une limite à l’esprit : une IA locale n’est pas nécessairement aussi performante que les modèles les plus puissants accessibles en ligne. Le résultat dépend du modèle, de son entraînement, de sa taille et de la tâche demandée. Un modèle compact peut être excellent pour une opération précise sans égaler un service cloud haut de gamme sur des raisonnements difficiles.
Peut-on aussi créer son propre assistant IA ?
Oui, et c’est là que l’approche devient particulièrement intéressante.
Un modèle local peut servir de base à un assistant spécialisé : rechercher des informations dans des documents personnels, aider à rédiger, classer des fichiers ou assister un développeur. Avec les bons outils, il peut être intégré à des applications et à des automatisations.
Il faut toutefois distinguer le modèle et l’environnement qui l’entoure. Installer un LLM ne lui donne pas automatiquement accès à Internet, à vos fichiers ou à vos applications. Ces fonctions nécessitent des intégrations supplémentaires, qu’il faut configurer et sécuriser.
Pour les usages plus avancés, cette approche rejoint le développement des agents IA. Nous avons exploré cette évolution dans notre article sur les agents IA et la blockchain, où les logiciels ne se contentent plus de répondre à une question, mais peuvent enchaîner plusieurs opérations.
Le matériel domestique peut déjà permettre d’expérimenter avec des agents simples. En revanche, faire tourner plusieurs agents simultanément ou leur confier des tâches longues augmente les besoins en mémoire et en puissance de calcul.
NVIDIA explore également cette logique avec Personal AI Router (PAIR), un outil capable de répartir des requêtes indépendantes entre plusieurs machines compatibles d’un même réseau. Attention à une nuance importante : PAIR distribue les requêtes entre les machines ; il ne fusionne pas leurs mémoires graphiques pour faire tenir un modèle géant dans une seule mémoire virtuelle.
Les limites à ne pas sous-estimer
L’IA locale offre plus de contrôle, mais elle ne résout pas tout.
La première limite est la consommation de ressources. Un modèle peut utiliser beaucoup de mémoire, solliciter le GPU et augmenter la consommation électrique. Pour un usage fréquent, cela mérite d’être pris en compte, particulièrement si la machine reste allumée longtemps.
La deuxième concerne la qualité. Les petits modèles progressent rapidement, mais ils peuvent encore se tromper, inventer des informations ou rencontrer des difficultés sur des tâches complexes. Comme avec une IA en ligne, les réponses doivent être vérifiées lorsque l’enjeu est important.
Enfin, la confidentialité n’est pas automatique. Les données peuvent rester sur la machine, mais il faut vérifier les connexions réseau, les extensions installées et les intégrations tierces. Un modèle local mal configuré n’offre pas une garantie absolue de sécurité.
En 2026, faut-il investir dans un PC dédié à l’IA ?
Pour la majorité des curieux, la meilleure stratégie consiste à commencer avec l’ordinateur que l’on possède déjà. Installer Ollama ou LM Studio, tester quelques modèles compacts et identifier ses besoins réels permet de prendre une décision plus éclairée.
Si l’utilisation devient régulière, une machine disposant de 32 Go de RAM et d’un GPU avec suffisamment de VRAM représente une base intéressante. Pour travailler avec des modèles plus volumineux, les configurations dotées de 24 Go de VRAM ou davantage ouvrent de nouvelles possibilités, mais leur coût doit être mis en regard des usages envisagés.
Le bon ordinateur n’est donc pas nécessairement le plus cher. C’est celui qui fait tourner les modèles adaptés à vos tâches, à une vitesse acceptable, sans immobiliser un budget disproportionné.
L’IA locale n’a pas vocation à remplacer tous les services en ligne. Elle ajoute une autre possibilité : garder certains traitements chez soi, mieux maîtriser ses outils et expérimenter librement. Et à mesure que les modèles compacts et les logiciels progressent, cette possibilité devient accessible à un public toujours plus large.
À propos de l’auteur
Je suis Adrien Hassler, créateur d’AdrienTech, un média consacré à l’intelligence artificielle, aux nouvelles technologies, aux sciences, à l’astronomie et à la blockchain. Passionné par l’innovation, j’explore les technologies qui transforment notre environnement numérique et scientifique, avec l’envie de continuer à décrypter les innovations qui façonnent notre avenir.