Mistral Large 4 : l’IA française peut-elle vraiment rivaliser avec les géants américains ?
Mistral AI veut s’imposer parmi les acteurs qui comptent dans l’intelligence artificielle mondiale. Avec Large 4, annoncé le 6 octobre 2026, la société française présente un modèle de très grande taille, multimodal et conçu pour des usages allant du développement logiciel à l’analyse de documents. Le projet s’inscrit aussi dans une ambition politique et industrielle : réduire la dépendance européenne aux technologies américaines.
Mais faut-il y voir une véritable alternative aux modèles dominants ou une nouvelle démonstration de communication autour de la souveraineté numérique ? Les deux questions ne sont pas équivalentes. Les performances d’un modèle, son coût d’utilisation, les conditions de sa licence et la possibilité de le faire fonctionner sans dépendre de son fournisseur comptent davantage qu’un discours sur sa nationalité.
Pour juger Mistral Large 4, il faut donc dépasser le symbole et examiner les faits.
Un modèle gigantesque, mais que signifie vraiment un billion de paramètres ?
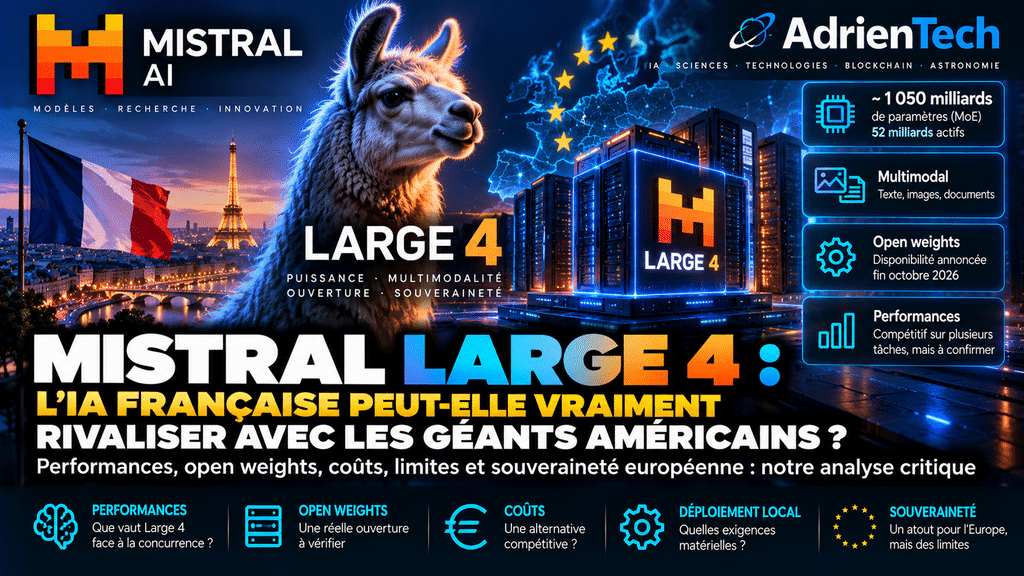
Mistral Large 4 repose sur une architecture dite Mixture of Experts, ou mélange d’experts. Selon la documentation de l’entreprise, le modèle compte environ 1 050 milliards de paramètres au total, dont une fraction seulement est activée pour chaque traitement. Mistral annonce environ 52 milliards de paramètres actifs, ainsi qu’une capacité multimodale permettant de traiter du texte et des images.
Ce choix architectural vise à combiner une capacité globale importante avec un coût de calcul inférieur à celui d’un modèle dense qui mobiliserait l’ensemble de ses paramètres à chaque étape.
Il faut toutefois éviter une confusion fréquente : un trillion de paramètres ne signifie pas automatiquement que le modèle est meilleur qu’un modèle plus petit. La taille est un indicateur technique, pas un classement universel de l’intelligence. La qualité des données d’entraînement, l’architecture, les méthodes d’optimisation et les capacités évaluées comptent également.
Le modèle est présenté comme adapté au développement logiciel, aux agents d’intelligence artificielle, à l’analyse de documents complexes et à certains usages professionnels spécialisés. Ce sont des domaines pertinents, mais les résultats doivent être examinés tâche par tâche.
Un modèle peut être très performant en programmation et moins convaincant dans le raisonnement scientifique, la compréhension de consignes longues ou l’utilisation fiable d’outils externes. Les performances générales ne dispensent donc pas de tester le modèle dans des conditions réelles.
Les performances annoncées résistent-elles à la comparaison ?
Mistral affirme que Large 4 améliore nettement ses capacités et rivalise avec plusieurs modèles concurrents. L’entreprise met notamment en avant le développement logiciel, les agents autonomes, le traitement multimodal et des usages professionnels.
Ces affirmations méritent d’être examinées, mais il faut distinguer trois niveaux de preuve : les résultats publiés par le fabricant, les évaluations indépendantes et les performances constatées par les utilisateurs dans leurs propres applications.
Les benchmarks sont utiles pour comparer des modèles sur des tâches définies. Ils ne constituent cependant pas une mesure absolue de leur qualité. Les résultats peuvent varier selon la version testée, les paramètres d’inférence, les outils autorisés, le coût de calcul et la sélection des exercices.
Des évaluations externes ont déjà placé Large 4 parmi les modèles ouverts compétitifs. Mais les classements restent mouvants et certains modèles chinois se montrent eux aussi particulièrement performants. Il serait donc prématuré de présenter Mistral comme le vainqueur incontestable du secteur.
La bonne question n’est pas de savoir si Large 4 « bat les Américains » dans l’absolu. Il faut demander sur quelles tâches, avec quel taux d’erreur, à quel prix et dans quelles conditions il fait mieux — ou moins bien — que les solutions concurrentes.
Pour une entreprise, un modèle légèrement moins performant mais moins cher, plus simple à déployer et mieux adapté à ses données peut être un choix plus pertinent qu’un modèle arrivé en tête d’un classement généraliste.
« Open weights » : une ouverture à vérifier, pas une garantie absolue
L’un des aspects les plus intéressants de Large 4 est la volonté annoncée de publier ses poids. Ces paramètres appris pendant l’entraînement permettent, lorsqu’ils sont distribués dans des conditions adaptées, de faire fonctionner le modèle dans une infrastructure choisie par l’utilisateur.
Cette possibilité change considérablement la relation au fournisseur. Une entreprise peut envisager un déploiement dans son propre environnement, étudier ses coûts d’exploitation et limiter certains transferts de données vers un service externe.
Mais il faut regarder le calendrier et les conditions concrètes. Au 28 octobre 2026, la publication des poids de Large 4 reste annoncée pour la fin du mois, sans disponibilité au téléchargement que nous puissions confirmer. Le modèle est accessible en préversion par l’intermédiaire de l’API de Mistral, ce qui ne correspond pas à une installation autonome.
Il existe donc une différence entre utiliser Large 4 dans le cloud de Mistral et disposer de ses poids pour le déployer soi-même.
La licence sera tout aussi importante. La publication de poids ne signifie pas nécessairement que les données d’entraînement, le code complet, les recettes de formation et tous les éléments du processus sont ouverts. Les droits d’utilisation commerciale, les restrictions éventuelles et les obligations de redistribution devront être lus dans les conditions officielles.
C’est pourquoi il serait trop tôt de qualifier sans nuance Large 4 d’« IA totalement open source ». Tant que les fichiers et leur licence ne sont pas disponibles et examinables, l’ouverture annoncée reste une promesse à vérifier.
Peut-on réellement faire tourner Large 4 chez soi ?
La taille du modèle soulève une autre question très concrète. Avec plus d’un billion de paramètres au total, Large 4 ne peut pas être considéré comme un modèle que l’on installe simplement sur un ordinateur personnel classique.
Dans une architecture à mélange d’experts, tous les paramètres ne sont pas activés à chaque génération, mais les poids doivent tout de même être stockés et rendus accessibles au système. La mémoire nécessaire dépendra notamment de leur précision numérique, de la quantification, du format de distribution et des optimisations disponibles.
Même lorsque le calcul est réparti entre plusieurs GPU, il faut disposer d’une infrastructure adaptée, d’une mémoire suffisante et d’un environnement logiciel compatible. Une version quantifiée pourrait faciliter certains déploiements, mais ses compromis en matière de qualité et de performance devront être mesurés.
Cela ne rend pas le modèle inutile. Des entreprises, des laboratoires et des fournisseurs spécialisés peuvent exploiter ce type d’architecture. En revanche, pour un particulier qui souhaite découvrir l’IA locale, des modèles plus petits seront généralement plus accessibles.
Nous avons détaillé ces contraintes dans notre guide consacré à l’IA locale et au choix d’un ordinateur en 2026. L’idée essentielle reste la même : le fait qu’un modèle soit téléchargeable ne signifie pas qu’il soit facile ou économique à exécuter.
L’ouverture technique ne garantit donc pas l’autonomie matérielle. C’est une limite importante lorsqu’on présente un modèle géant comme un outil de souveraineté.
Souveraineté européenne : une ambition réelle, mais pas une indépendance totale
Mistral occupe une place particulière dans le débat européen. L’entreprise est française, développe ses modèles en Europe et cherche à proposer une alternative aux grands fournisseurs américains. Elle peut contribuer à maintenir sur le continent des compétences en recherche, en ingénierie et en conception de modèles.
C’est un enjeu industriel sérieux. Si les entreprises européennes ne disposent que de solutions étrangères pour leurs usages les plus stratégiques, elles peuvent se retrouver dépendantes de décisions commerciales, de changements de conditions d’accès ou de contraintes juridiques qui échappent en partie à leur contrôle.
Cependant, la souveraineté ne se résume pas au siège social du fabricant. Elle dépend aussi de l’endroit où les données sont traitées, de la maîtrise des infrastructures, de la disponibilité des composants, de la gouvernance du fournisseur et de la capacité à changer de solution.
Mistral indique avoir entraîné Large 4 dans ses centres de données européens, sur une infrastructure mobilisant des milliers de GPU NVIDIA Grace Blackwell. Cela témoigne d’une capacité de calcul importante sur le continent, mais aussi d’une dépendance à des composants conçus par un acteur américain.
Cette dépendance n’annule pas l’intérêt du projet. La plupart des acteurs de l’IA avancée s’appuient sur une chaîne d’approvisionnement internationale. Mais elle rappelle que souveraineté européenne et indépendance technologique complète ne sont pas synonymes.
Pour évaluer les progrès réels, il faudra regarder l’ensemble de la chaîne : les puces, les centres de données, l’énergie, les logiciels, les compétences et les conditions de déploiement. Notre article sur les centres de données consacrés à l’IA en France et en Suisse aborde justement cette dimension matérielle souvent absente des débats sur les modèles.
Le prix et l’usage réel comptent autant que la technologie
Mistral propose Large 4 via son API, ce qui permet aux développeurs de tester ses capacités sans installer l’ensemble du modèle. La documentation tarifaire publiée par l’entreprise annonce un prix de référence de 1,36 dollar par million de jetons en entrée et de 4,18 dollars par million de jetons en sortie, avec une tarification distincte pour les entrées mises en cache.
Ces prix ne suffisent pas à eux seuls à déterminer le coût total d’une application. Il faut aussi considérer le volume de requêtes, la longueur des réponses, les appels aux outils, les délais de traitement et les éventuelles erreurs qui obligent à recommencer une opération.
Pour une entreprise qui utilise un agent IA, le coût pertinent n’est pas seulement le prix d’un million de jetons. C’est le coût nécessaire pour accomplir une tâche correctement, de manière répétable et avec un niveau de supervision acceptable.
Une solution moins chère par requête peut revenir plus cher si elle échoue souvent ou nécessite de longues instructions. À l’inverse, un modèle coûteux peut être rentable s’il réduit les interventions humaines sur des tâches complexes.
La comparaison avec les concurrents devra donc porter sur des scénarios identiques : mêmes documents, mêmes consignes, mêmes outils et critères de réussite définis à l’avance. C’est à cette condition que les entreprises pourront déterminer si Large 4 présente un avantage opérationnel.
Mistral doit maintenant transformer l’annonce en preuve
Large 4 montre que Mistral reste capable de développer un modèle de grande ampleur et de se positionner sur des usages professionnels exigeants. L’initiative est intéressante pour l’écosystème européen, notamment si la publication des poids permet à davantage d’organisations d’expérimenter le modèle et de le déployer selon leurs besoins.
Mais plusieurs éléments restent à confirmer : la disponibilité effective des poids, les conditions de licence, les performances indépendantes, les besoins matériels et les coûts réels dans des applications concrètes.
Il faut aussi se garder d’une lecture trop nationale de la compétition. Une technologie n’est pas bonne parce qu’elle est française, pas plus qu’elle ne serait mauvaise parce qu’elle vient des États-Unis ou de Chine. Les critères pertinents sont la qualité, la fiabilité, le coût, la sécurité, la transparence et la liberté réelle laissée aux utilisateurs.
Mistral Large 4 mérite donc d’être suivi, mais pas d’être célébré avant l’heure. Si les poids sont publiés dans des conditions suffisamment ouvertes et si les résultats annoncés se confirment dans des évaluations indépendantes, le modèle pourrait constituer une alternative crédible pour certains usages. Si les conditions d’accès restent restrictives ou si les avantages pratiques ne se vérifient pas, le discours sur la souveraineté ne suffira pas à compenser ces limites.
La vraie réussite de Mistral ne se mesurera pas au nombre de paramètres affichés ni aux déclarations de ses dirigeants. Elle se mesurera à la capacité des utilisateurs à obtenir de meilleurs résultats, à des coûts acceptables, avec un contrôle réel sur leurs données et leurs infrastructures.
À propos de l’auteur
Je suis Adrien Hassler, créateur d’AdrienTech, un média consacré à l’intelligence artificielle, aux nouvelles technologies, aux sciences, à l’astronomie et à la blockchain. Passionné par l’innovation, j’explore les technologies qui transforment notre environnement numérique et scientifique, avec l’envie de continuer à décrypter les innovations qui façonnent notre avenir.